Kompjuterët kuantikë mund të ndihmojnë në parashikimin e kancerit të mushkërive me pak të dhëna
Në këtë artikull
Studiuesit po shqyrtojnë mënyra të reja për të përdorur kompjuterët kuantikë dhe inteligjencën artificiale në analizimin e të dhënave shëndetësore, veçanërisht kur numri i rasteve të disponueshme për trajnim është i kufizuar. Një studim i ri nga Universiteti Florida Atlantic (FAU) ka krahasuar disa metoda të mësimit makinerik kuantik për parashikimin e kancerit të mushkërive, duke raportuar rezultate premtuese në një eksperiment me të dhëna të strukturuara.
Ekipi, i udhëhequr nga Arslan Munir, profesor i inxhinierisë elektrike dhe shkencave kompjuterike në FAU, testoi algoritme të ndryshme si në simulime kompjuterike, ashtu edhe në pajisje reale kuantike.
Reklamë
Studimi, i publikuar në revistën shkencore Discover Quantum Science të Springer Nature, shqyrton se si performojnë këto metoda kur modelet trajnohen me një sasi të kufizuar të dhënash.
Si u përdorën të dhënat për parashikimin e kancerit?
Studiuesit nisën me një grup të dhënash publike që përmbante 309 regjistrime me informacione mbi faktorë rreziku dhe simptoma, përfshirë historinë e pirjes së duhanit, kollën, fishkëllimën gjatë frymëmarrjes, lodhjen dhe dhimbjen e kraharorit. Të dhënat përfshinin gjithashtu një etiketë që tregonte nëse regjistrimi lidhej me kancerin e mushkërive.
Për të balancuar kategoritë me dhe pa kancer, ekipi përdori një metodë statistikore që krijon shembuj sintetikë. Në këtë mënyrë, grupi eksperimental u zgjerua në 540 mostra.
Këto mostra shtesë nuk përfaqësonin pacientë të rinj. Ato ishin të dhëna të krijuara artificialisht për të ndihmuar në balancimin e grupit të përdorur gjatë eksperimentit.
Më pas, një metodë optimizimi për përzgjedhjen e veçorive reduktoi numrin e variablave hyrëse në 10, duke u përqendruar te informacioni që mund të ishte më i dobishëm për klasifikimin.
Tri metoda kuantike u krahasuan në të njëjtat kushte
Ekipi vlerësoi tri qasje për klasifikimin e të dhënave:
- Quantum Support Vector Machines (QSVM): metoda që përdor parime të mësimit makinerik dhe teknika kuantike për të dalluar kategoritë.
- Quantum k-Nearest Neighbors (QKNN): qasje që klasifikon të dhënat duke analizuar ngjashmëritë mes shembujve.
- Quantum Boosting: metodë që synon të përmirësojë klasifikimin përmes kombinimit të teknikave të të mësuarit.
Eksperimentet përfshinë dy qasje kryesore të kompjuterëve kuantikë: llogaritjen kuantike të bazuar në porta (gate-based quantum computing) dhe optimizimin përmes pjekjes kuantike (quantum annealing).
Për testimin u përdorën disa platforma dhe mjete softuerike, përfshirë Qiskit, Cirq, PennyLane, OpenJij dhe D-Wave.
Sipas përshkrimit të studimit, në secilin prej pesë raundeve të vlerësimit, modelet u trajnuan me 108 mostra dhe u testuan me 432 të tjerat. Ky konfigurim i lejoi studiuesit të shqyrtonin performancën e modeleve kur të dhënat e trajnimit ishin të kufizuara.
D-Wave regjistroi saktësinë më të lartë në eksperiment
Rezultatin më të lartë të raportuar në vlerësimin kryesor e arriti një metodë e bazuar në Quantum Support Vector Machine, e zbatuar me kompjuterët kuantikë të tipit annealing të kompanisë D-Wave.
Sipas studimit, metoda arriti:
- 94,31% saktësi në simulim.
- 91,90% saktësi në pajisjen kuantike fizike.
Testimi në pajisje reale u mundësoi studiuesve të shqyrtonin performancën përtej një mjedisi vetëm të simuluar.
Megjithatë, këto shifra nuk duhet të interpretohen si provë se teknologjia mund të diagnostikojë me të njëjtën saktësi pacientët në praktikën klinike. Rezultatet lidhen me grupin e të dhënave të zgjeruar artificialisht dhe me procedurën e veçantë të vlerësimit të përdorur në studim.
Përfaqësuesja e D-Wave Quantum Inc., Catherine Potts, tha se hulumtimi tregon potencialin e kompjuterëve kuantikë për të analizuar të dhëna në situata ku informacioni i disponueshëm është i kufizuar. Sidoqoftë, përcaktimi i dobisë reale në kujdesin shëndetësor kërkon vlerësime të mëtejshme.
Pse rezultatet nuk janë ende gati për përdorim klinik?
Studiuesit theksojnë se gjetjet janë paraprake. Grupi i të dhënave përmbante simptoma dhe faktorë rreziku, por jo imazhe mjekësore, rezultate patologjike, analiza laboratorike apo informacione mbi fazën e kancerit.
Për këtë arsye, modeli nuk përfaqëson një sistem të plotë diagnostikues dhe rezultatet nuk provojnë se ai mund të zbulojë me besueshmëri kancerin te pacientët e rinj.
Një hap tjetër i rëndësishëm do të jetë testimi në grupe të pavarura të dhënash nga institucione të ndryshme. Kjo do të ndihmojë për të kuptuar nëse rezultatet mund të përsëriten në popullata të tjera dhe në kushte më pranë praktikës klinike.
Ekipi planifikon gjithashtu të shqyrtojë kombinimin e simptomave me të dhëna nga imazheria mjekësore ose gjenomika, si dhe të zhvillojë metoda që e bëjnë më të kuptueshme mënyrën se si modelet arrijnë në parashikimet e tyre.
Universiteti Florida Atlantic investon në teknologjinë kuantike
Studimi është pjesë e përpjekjeve të Universitetit Florida Atlantic për të lidhur kërkimin në llogaritjen kuantike me aplikime konkrete. Universiteti ka investuar në kërkime, arsim dhe infrastrukturë përmes Qendrës për Teknologjitë Kuantike.
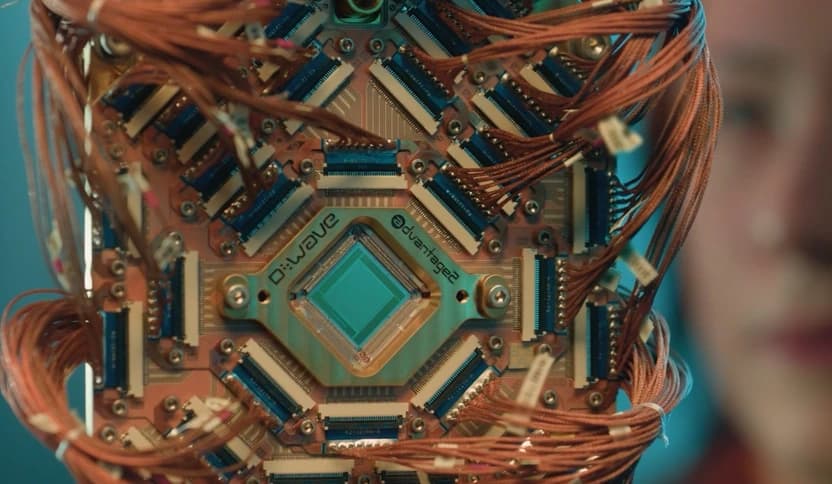
Një nga këto investime është instalimi i një kompjuteri kuantik D-Wave Advantage2 në kampusin e universitetit në Boca Raton, Florida, për t’u dhënë studiuesve dhe studentëve qasje në këtë teknologji.
Në të ardhmen, kombinimi i llogaritjes kuantike me inteligjencën artificiale mund të ofrojë mënyra të reja për të analizuar të dhëna komplekse. Megjithatë, përpara se këto metoda të përdoren në vendimmarrjen mjekësore, nevojiten testime të pavarura, validim klinik dhe vlerësim i kujdesshëm i kufizimeve të tyre.
Studimi shkencor: “Inferring lung cancer under limited learning data through gate-based and annealing-based quantum techniques”, Discover Quantum Science, Springer Nature.
Kufizimet e studimit
Studiuesit theksojnë se rezultatet janë paraprake dhe nuk përbëjnë provë se modeli mund të përdoret për diagnostikimin e kancerit të mushkërive në praktikën klinike. Studimi u bazua në 309 regjistrime fillestare, të cilat u zgjeruan në 540 mostra përmes një metode që gjeneron të dhëna sintetike. Për rrjedhojë, saktësia prej 94,31% në simulim dhe 91,90% në pajisjen kuantike pasqyron performancën e modelit në kushtet eksperimentale të këtij studimi, jo saktësinë e tij të provuar te pacientët.
Një çështje metodologjike që meriton vëmendje është renditja e hapave të përpunimit të të dhënave. Sipas artikullit shkencor, metoda SMOTE u aplikua përpara ndarjes së të dhënave në grupet e trajnimit dhe testimit. Kjo qasje mund të krijojë rrezik të rrjedhjes së të dhënave (data leakage), nëse mostrat sintetike të krijuara nga vëzhgimet fillestare përfundojnë në grupe të ndryshme. Në raste të tilla, rezultatet e vlerësimit mund të jenë më optimiste se performanca në të dhëna vërtet të pavarura.
Për të vlerësuar më tej besueshmërinë e rezultateve, nevojiten testime në grupe të pavarura, me të dhëna reale klinike dhe me balancimin e klasave të kryer vetëm brenda grupit të trajnimit. Autorët gjithashtu theksojnë nevojën për kërkime të mëtejshme përpara se kjo qasje të mund të shqyrtohet për përdorim në kujdesin shëndetësor.
Burimet
1. Studimi origjinal — Springer Nature, Discover Quantum Science. Përshkruan grupin fillestar prej 309 regjistrimesh, zgjerimin në 540 mostra, metodën SMOTE, protokollin e vlerësimit dhe rezultatet e raportuara.
Lexo studimin shkencor.
2. Dokumentacioni i imbalanced-learn. Shpjegon se aplikimi i metodave të mbimostrimit përpara ndarjes së të dhënave mund të shkaktojë rrjedhje të të dhënave dhe të çojë në vlerësime tepër optimiste.
Common pitfalls and recommended practices.
3. Studim metodologjik mbi mbimostrimin dhe validimin e kryqëzuar. Shpjegon pse SMOTE duhet të aplikohet brenda grupeve të trajnimit gjatë validimit, në vend që të aplikohet mbi të gjithë grupin e të dhënave përpara ndarjes.
Joint use of over- and under-sampling techniques and cross-validation
Reklamë